
この記事でわかること
- Dev・Stage・Prod を分け、共有のレジストリを昇格のゲートにして AKS でオンライン推論する Azure Machine Learning のベースライン
- マネージド VNet と自分の VNet の 2 つのネットワーク、Application Gateway と API Management の受信の流れ
- Kubernetes オンライン エンドポイントの認証(トークンの交換)、ブルー/グリーンのロールアウトなど運用のポイント
はじめに
Azure アーキテクチャ センターのアーキテクチャを 1 つずつ読む 25 回目。
今回は「ベースライン Azure Machine Learning 推論参照アーキテクチャ」を読む。
一般的な企業の環境での、Azure Machine Learning のオンライン推論の基準になる構成で、プライベートなネットワーク、環境の分離、モデルの制御された昇格、チームの責任の分離を重視している。
前回:基本の Foundry チャットとランディング ゾーン版(アーキテクチャ解説シリーズ 24)
Azure Machine Learning 推論のベースラインとは
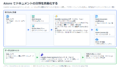
Dev、Stage、Prod の 3 つの環境を、それぞれ別のサブスクリプションに置く。
トレーニングは Dev で行い、バージョン管理したモデルと環境を共有の Azure Machine Learning レジストリに公開して、推論の環境である Stage と Prod に昇格させる。
推論のホストは AKS で、Azure Machine Learning 拡張機能が Kubernetes オンライン エンドポイントを提供し、ブルー/グリーンのロールアウトとトラフィックの移動を管理する。
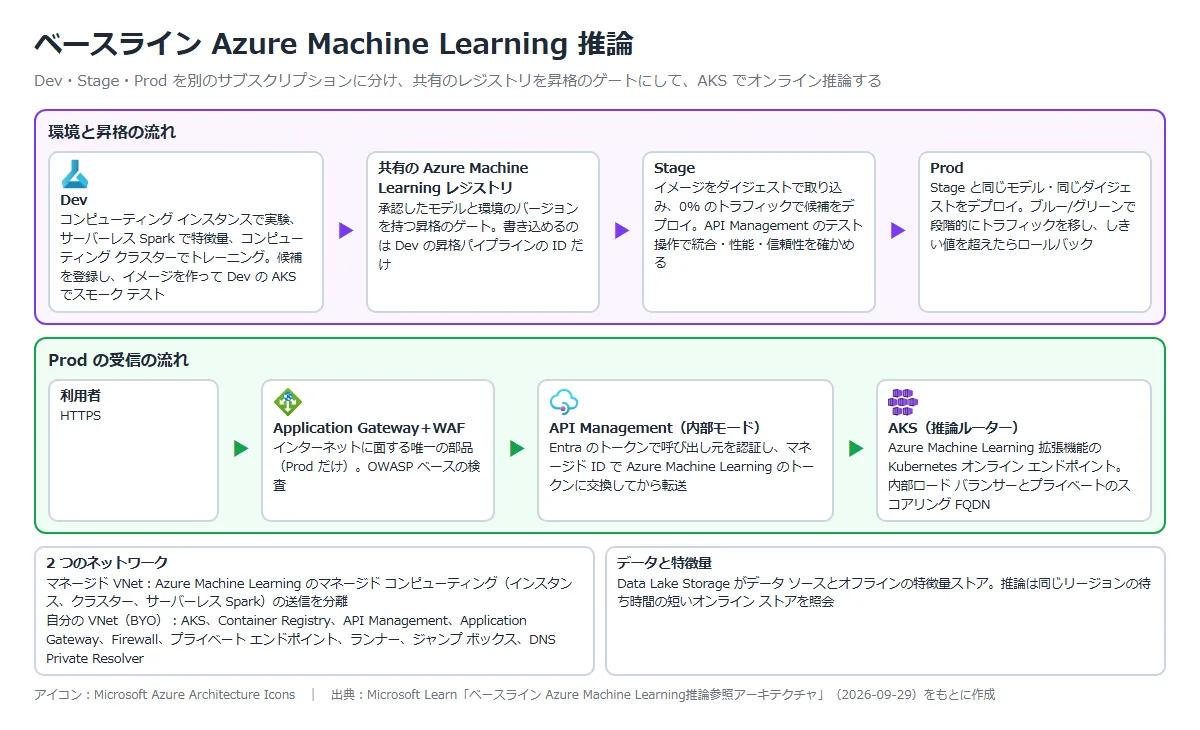
このアーキテクチャはオンライン推論に重点を置き、ストリーミング推論は範囲外。1 つのリージョンの構成。
| 面 | 内容 |
|---|---|
| データと特徴量 | Data Lake Storage がデータ ソースとオフラインの特徴量ストア。 待ち時間の短いオンライン ストアで要求時に参照する |
| 機械学習 | Azure Machine Learning のワークスペース、トレーニングのコンピューティング、モデルの登録、環境、エンドポイントとデプロイの定義 |
| 推論 | AKS が Kubernetes オンライン エンドポイントの後ろで推論する。 ブルー/グリーンのトラフィックは Azure Machine Learning が制御 |
| アクセスと運用 | Application Gateway(WAF)、API Management、Azure Firewall、プライベート エンドポイント、ハイブリッド DNS、セルフホステッドのランナー、ジャンプ ボックス |
構成要素がどういうものかは、次のとおり。
| 構成要素 | どういうもの | 役割 |
|---|---|---|
| Azure Machine Learning のワークスペース | 機械学習の作業の入れ物。環境ごとに 1 つ | 各ワークスペースは自分の Key Vault、Storage、Container Registry、Application Insights を持ち、プライベート エンドポイントからだけ届く |
| Azure Machine Learning レジストリ | モデルと環境のバージョンを、ワークスペースをまたいで共有する場所 | 昇格のゲート。 共有プラットフォームのサブスクリプションに 1 つ置く(Prod に置くと Dev が本番に依存する) |
| AKS と Azure Machine Learning 拡張機能 | Kubernetes のマネージド サービスと、その上で推論のエンドポイントを動かす拡張機能。 AKS はAKS のベースライン アーキテクチャ。 | 環境ごとに 1 つのクラスター(ワークスペースと同じサブスクリプション)。 推論ルーターを内部ロード バランサーで公開する |
| Azure Container Registry(Premium) | 推論のイメージを置くレジストリ | 環境ごとにプライベート エンドポイントの後ろに置く。 Stage と Prod には、ダイジェストで取り込んだイメージ |
| 構成要素 | どういうもの | 役割 |
|---|---|---|
| API Management | API のゲートウェイ。Stage と Prod に内部モードで置く | 利用者の Entra のトークンを検証し、Azure Machine Learning のトークンに交換してエンドポイントに転送する |
| Application Gateway と WAF | レイヤー 7 のロード バランサーと WAF。 詳しくはAzure WAF(Application Gateway)とは。 | インターネットに面する唯一の部品で、Prod だけに置く |
| Azure Key Vault | シークレット、キー、証明書の保管庫。 詳しくはAzure Key Vault とは。 | ワークスペースのシークレット、推論ルーターの TLS 証明書。 トークン交換ができない場合はエンドポイントのキー |
| Azure DNS Private Resolver | ハイブリッドの名前解決。 詳しくはAzure DNS Private Resolver とは。 | プライベート エンドポイント、推論ルーターの FQDN を、Azure とオンプレミスから同じように解決する |
公式ドキュメント:ベースライン Azure Machine Learning推論参照アーキテクチャ | Microsoft Learn
環境の昇格
| 引き継ぎ | 条件 |
|---|---|
| Dev → レジストリ | 候補のモデルが Dev の AKS でスモーク テストに通り、トレーニング ジョブとイメージのダイジェストへの系列が記録され、デプロイ定義がバージョン管理されている。 レジストリに書けるのは Dev の昇格パイプラインの ID だけ |
| レジストリ → Stage | 公開されると自動で引き継ぐ。 イメージはダイジェストで取り込み、0% のトラフィックで新しいデプロイとして置く |
| Stage → Prod | Application Gateway からの受信の流れ全体で機能・非機能のチェックに通り、ロールバックを試し、セキュリティの対策を確かめた。 リリースの承認者が証拠を見て承認する |
| Prod → Dev | インシデント、ドリフト、パフォーマンスの観察を、次の繰り返しの計画に戻す |
Stage では、API Management のテスト用の操作で、候補のデプロイ名に向けて azureml-model-deployment ヘッダーを上書きし、ふつうの利用者にデプロイの選択を見せずに候補を検証する。
公式ドキュメント:ベースライン Azure Machine Learning推論参照アーキテクチャ | Microsoft Learn
ネットワークと認証
| 項目 | ポイント |
|---|---|
| 2 つのネットワーク | Azure Machine Learning のマネージド VNet は、コンピューティング インスタンス、クラスター、サーバーレス Spark の送信を分離する。 それ以外(AKS、Container Registry、API Management、Application Gateway、Firewall、プライベート エンドポイント、ランナー、ジャンプ ボックス)は自分で作る VNet に置く |
| サブネット | サブネットごとに NSG を当て、必要な通信だけを明示的に許可する |
| 推論ルーター | 拡張機能は推論を有効にし、内部ロード バランサーで公開し、安全でない接続を許さず、CA 発行の証明書とプライベートのスコアリング FQDN を設定する。 高可用性を保ち、システム ノード プールを可用性ゾーンに分ける |
| エンドポイントの認証 | Kubernetes オンライン エンドポイントは Entra のトークン(aad_token)に対応せず、キーか Azure Machine Learning のトークン(aml_token)。 API Management だけを呼び出し元にし、マネージド ID で特定のエンドポイントのトークン取得だけを許すカスタム ロールで交換する |
公式ドキュメント:ベースライン Azure Machine Learning推論参照アーキテクチャ | Microsoft Learn
構成のポイント
| 柱 | ポイント |
|---|---|
| 信頼性 | 推論ルーターの高可用性を保ち、システム ノード プールを可用性ゾーンに分ける。 Prod はブルー/グリーンで段階的にトラフィックを移し、しきい値でロールバックする |
| セキュリティ | インターネットに面するのは Prod の Application Gateway だけ。 ワークスペースや関連リソースはプライベート エンドポイント。 API Management に、デプロイやキーの一覧、ワークスペース全体の権限を与えない。 Azure Machine Learning のトークンを名前付き値や Key Vault、ソース管理に置かない |
| オペレーショナル エクセレンス | エンドポイントの定義、デプロイの設定、トラフィックの構成をソース管理でバージョン管理する。 レジストリのネットワークを分離すると、スタジオではレジストリの操作が見えないので、ランナーやジャンプ ボックスから CLI か SDK を使う |
公式ドキュメント:ベースライン Azure Machine Learning推論参照アーキテクチャ | Microsoft Learn
構築手順
今回の構成と実施すること
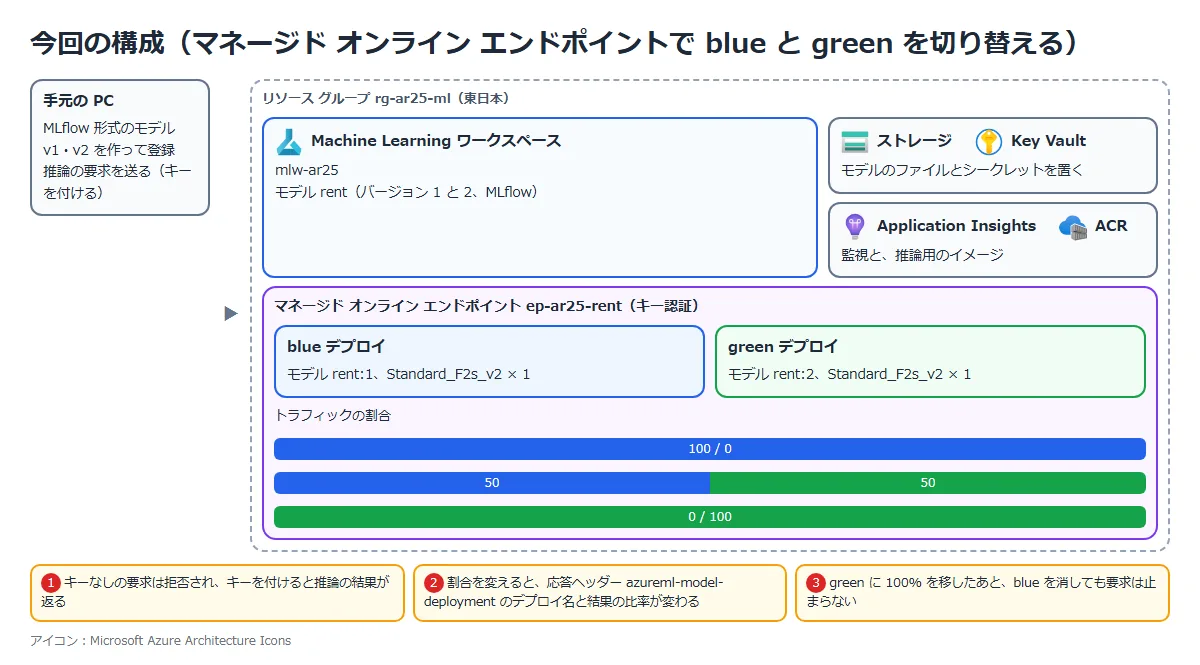
記事の構成のうち、Prod の「0% から始めるブルー/グリーン」の部分を、1 つのワークスペースとマネージド オンライン エンドポイントで試した。
AKS(Kubernetes オンライン エンドポイント)、レジストリ、Application Gateway と API Management は使っていない。
モデルは、架空のデータ(広さと駅からの分数から家賃を出す)で作った小さな回帰モデルで、v1 と v2 で答えが少し違うようにした。
| 手順 | 実施すること | 確かめること |
|---|---|---|
| ① | ポータルで Machine Learning ワークスペースを作る | 一緒に作られる関連リソース |
| ② | MLflow 形式のモデルを登録し、スタジオでエンドポイントと blue のデプロイを作る | キーなしの要求は拒否され、キーを付けると推論の結果が返る |
| ③ | green のデプロイを 0% で足す | ヘッダーでデプロイを指定すれば、割合が 0% でも呼べる |
| ④ | トラフィックを 50/50 → 0/100 にし、blue を消す | 割合どおりに振り分けられ、切り替えや削除の間も要求が止まらない |
デプロイの VM は Standard_F2s_v2(2 コア、4 GiB)で、Linux の VM と同じ 16.9306 円/時がかかる。
blue と green の 2 台を合わせて、作り直しの時間も含め約 2 時間動かした。
ほかに、デプロイのときに自動で作られるコンテナー レジストリ(Basic、26.3611 円/日)と、ストレージなどの少額がかかる。
公式ドキュメント:リアルタイム推論のためのオンライン エンドポイントのデプロイ | Microsoft Learn
① ポータルで Machine Learning ワークスペースを作る
ポータルの「Azure Machine Learning」⇒「作成」で作る。
名前を入れると、ストレージ アカウント、キー コンテナー、Application Insights が新規で埋まる。
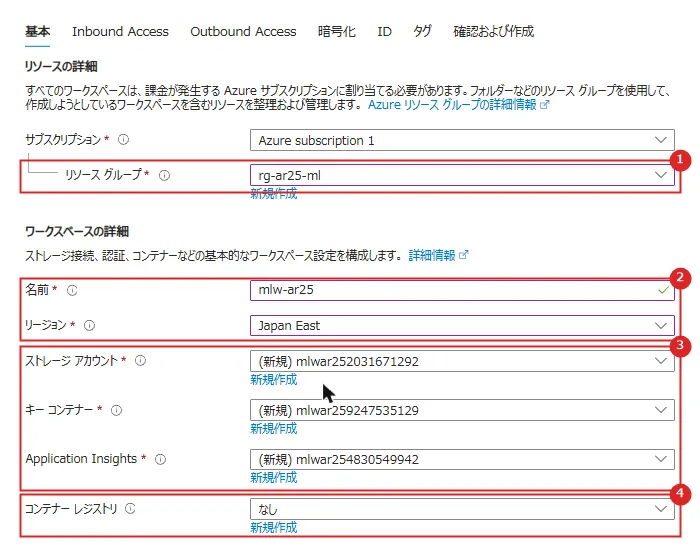
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | リソース グループ | rg-ar25-ml |
| 2 | 名前、リージョン | mlw-ar25、Japan East |
| 3 | ストレージ アカウント、キー コンテナー、Application Insights | 関連リソース。 既定で新しく作られる |
| 4 | コンテナー レジストリ | 既定は「なし」。 今回は、最初のデプロイのときに Basic のレジストリが自動で作られた |
受信(Inbound Access)は「All networks」、送信(Outbound Access)は「パブリック」のままにした。
記事の構成のように、ワークスペースをプライベート エンドポイントやマネージド VNet で閉じるのは、ここで選ぶ。
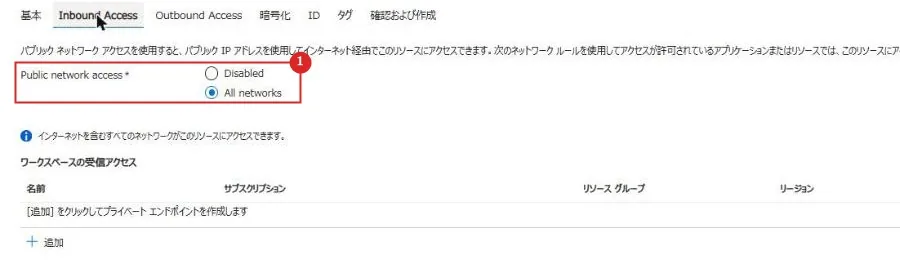
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | Public network access | All networks(インターネットからワークスペースにアクセスできる)。 Disabled にすると、下の欄でプライベート エンドポイントを足す |
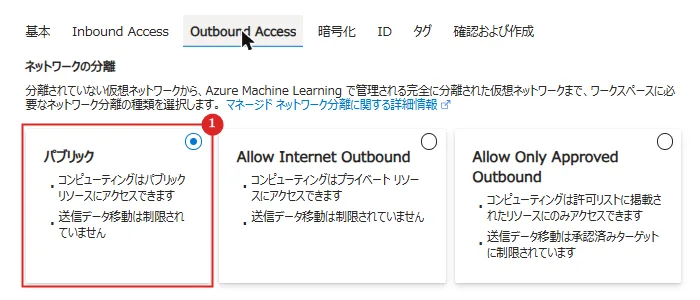
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | パブリック | マネージド VNet を使わない。 Allow Internet Outbound か Allow Only Approved Outbound を選ぶと、Machine Learning が管理する VNet でコンピューティングを分離する |
作成後のリソース グループには、ワークスペース、ストレージ、キー コンテナー、Application Insights、Log Analytics ワークスペースができた。
② モデルを登録し、エンドポイントと blue を作る
モデルは手元の scikit-learn で作り、MLflow 形式(MLmodel、model.pkl、conda.yaml)のフォルダーにした。
MLflow 形式なら、スコアリング スクリプトと環境を用意しなくてもデプロイできる(コードなしのデプロイ)。
conda.yaml に推論用のパッケージが要ることでつまずいた(後述)。
最終的に使った conda.yaml は次のとおり。
channels:
- conda-forge
dependencies:
- python=3.10
- pip
- pip:
  - mlflow-skinny
  - cloudpickle
  - psutil
  - pandas
  - scikit-learn==1.0.2
  - numpy<2
  - azureml-inference-server-http
  - azureml-ai-monitoring
name: mlflow-env
モデルの登録は、画面のない操作なので CLI で行った。
az ml model create -g rg-ar25-ml -w mlw-ar25 -n rent -v 5 --type mlflow_model --path ./rent-v1
az ml model create -g rg-ar25-ml -w mlw-ar25 -n rent -v 6 --type mlflow_model --path ./rent-v2
登録したモデルを Machine Learning スタジオで開き、「このモデルを使用する」⇒「リアルタイム エンドポイント」を選ぶ。
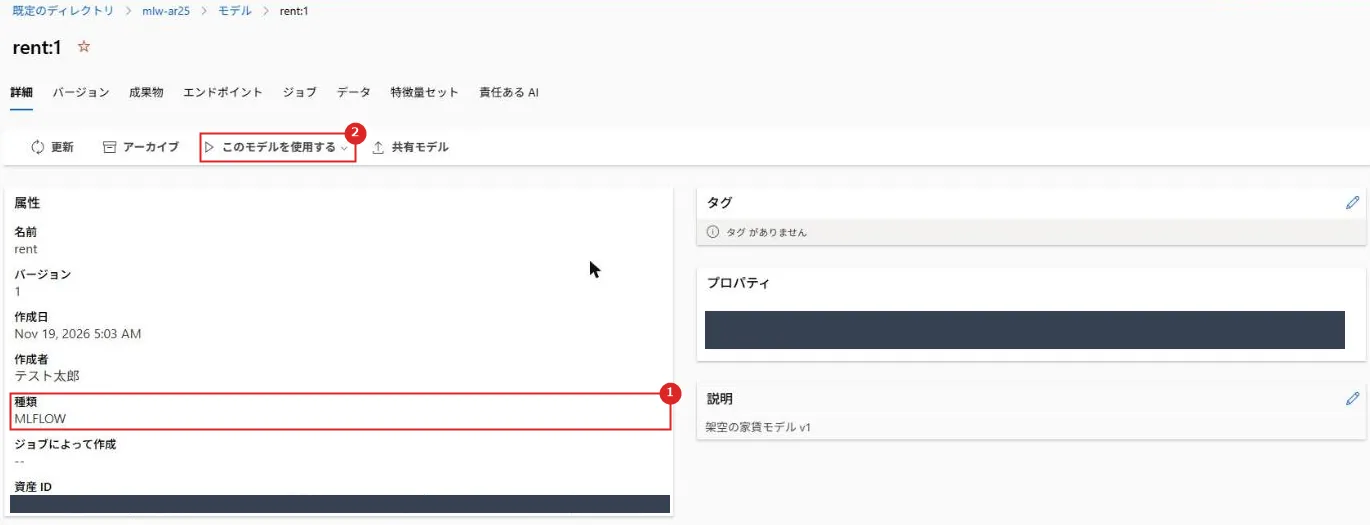
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | 種類 | MLFLOW。 MLflow 形式として登録されている |
| 2 | このモデルを使用する | リアルタイム エンドポイント、バッチ エンドポイントなどへのデプロイを始める |
デプロイの画面は、既定でインスタンス数が 3、仮想マシンが Standard_D2as_v4 になっていた。
1 台の Standard_F2s_v2 に変え、エンドポイント名とデプロイ名を入れた。
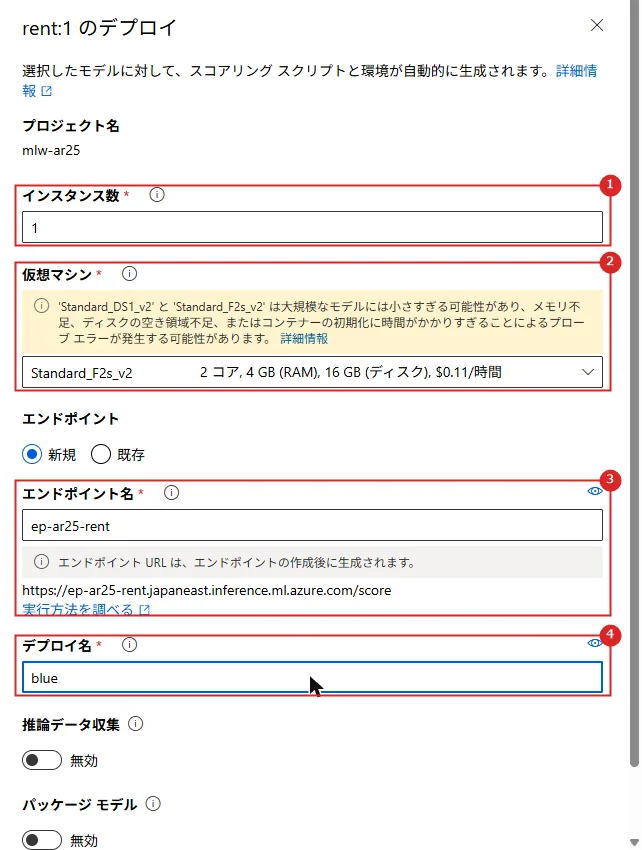
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | インスタンス数 | 1。 既定の 3 のままだと、3 台分の料金がかかる |
| 2 | 仮想マシン | Standard_F2s_v2。 大きなモデルには小さすぎることがある、という注意が出る(今回のモデルは数 KB) |
| 3 | エンドポイント名 | ep-ar25-rent。 URL は https://ep-ar25-rent.japaneast.inference.ml.azure.com/score になる |
| 4 | デプロイ名 | blue |
マネージド オンライン エンドポイントでは、Azure Machine Learning が OS の更新などのために 20% 分の余分なクォータを確保する。
F2s_v2 を 1 台デプロイするには、ceil(1.2 × 1) × 2 コア = 4 コアの空きが要る。
blue と green の 2 つで 8 コアになり、東日本の Machine Learning の standardFSv2Family のクォータ(16 コア)に収まった。
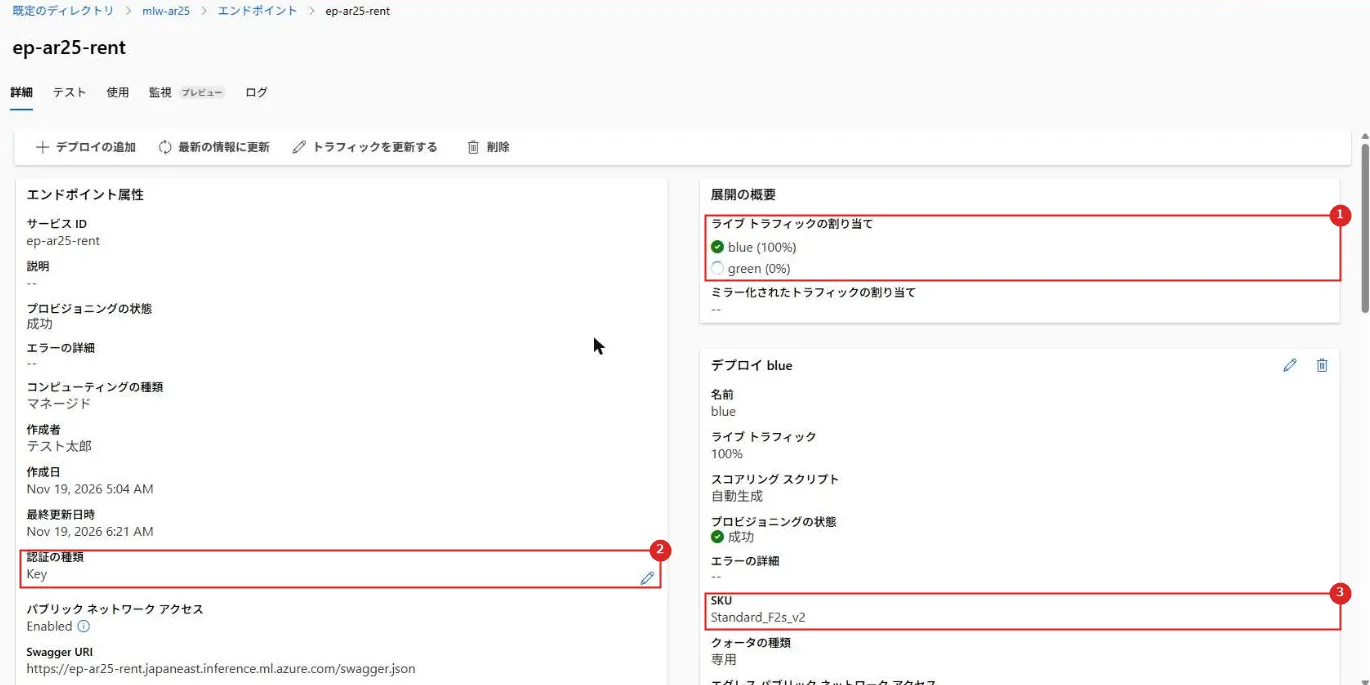
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | ライブ トラフィックの割り当て | blue に 100%。 green は作成中で 0% |
| 2 | 認証の種類 | Key。 スタジオから作るとキー認証になった |
| 3 | SKU | Standard_F2s_v2 |
キーを付けずに要求を送ると、403 Forbidden で拒否された。
キーを付けると、v1 のモデルの答えが返った。
応答ヘッダー azureml-model-deployment に、答えたデプロイの名前が入る。
要求の本文は {"input_data": {"columns": ["area_m2", "walk_min"], "index": [0], "data": [[40, 5]]}}(40 ㎡、徒歩 5 分)で、スコアリング URI に POST した。
キーは「Authorization: Bearer <キー>」のヘッダーで渡す(キーは az ml online-endpoint get-credentials で取れる)。
v1 の答えは [96.00000000000001]、v2 は [100.76669425164522] だった。
公式ドキュメント:
MLflow モデルのオンライン エンドポイントへのデプロイ | Microsoft Learn
Azure Machine Learning を使用するリソースのクォータと制限の管理と引き上げ | Microsoft Learn
オンライン エンドポイントの認証と承認 | Microsoft Learn
③ green を 0% で足す
green のデプロイは、YAML を書いて CLI で作った。
エンドポイントに後から足したデプロイは、トラフィックが 0% で始まる。
$schema: https://azuremlschemas.azureedge.net/latest/managedOnlineDeployment.schema.json
name: green
endpoint_name: ep-ar25-rent
model: azureml:rent:6
instance_type: Standard_F2s_v2
instance_count: 1
az ml online-deployment create -g rg-ar25-ml -w mlw-ar25 -f green.ymlgreen ができたあとも、割合どおり(blue 100、green 0)に 20 回送ると、20 回とも blue(96.0)が答えた。
要求にヘッダー azureml-model-deployment: green を付けると、割合を無視して green(100.77)に届いた。
本番のトラフィックを流す前に、新しいデプロイだけを試せる。
なお、blue の割合が 0% で、ほかに割合を持つデプロイがない状態では、キーを付けても 404 Not Found になった。
公式ドキュメント:
リアルタイム推論のためのオンライン エンドポイントのデプロイ | Microsoft Learn
リアルタイム推論のために新しいデプロイの安全なロールアウトを実行する | Microsoft Learn
④ トラフィックを 50/50 → 0/100 にし、blue を消す
スタジオのエンドポイントの「トラフィックを更新する」で割合を変える。
割合の合計は 0% か 100% にする。
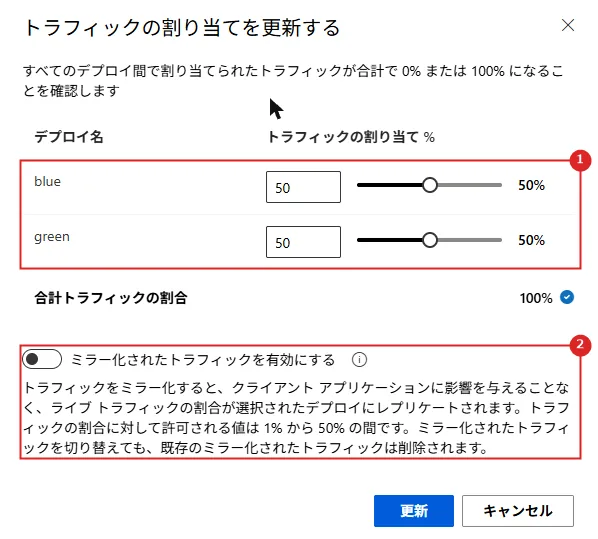
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | blue、green | 50 と 50 にした |
| 2 | ミラー化されたトラフィックを有効にする | ライブ トラフィックの一部(1〜50%)を、応答に使わずに別のデプロイへ複製する。 今回は使っていない |
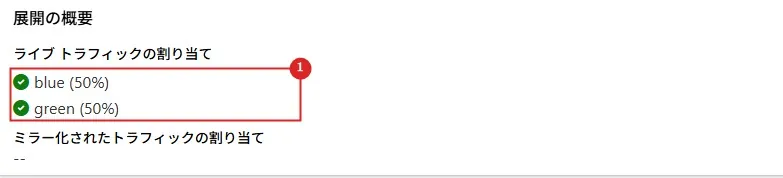
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | ライブ トラフィックの割り当て | blue(50%)、green(50%) |
50/50 にしたあと 40 回送ると、blue が 21 回、green が 19 回答えた。
続けて 0/100 にし、更新を押した直後から 75 秒間、0.5 秒おきに要求を送った。
140 回のうちエラーは 0 件で、最初の 1 回だけ blue、そのあとはすべて green が答えた。
| 割合(blue / green) | 送った回数 | blue が答えた | green が答えた |
|---|---|---|---|
| 100 / 0 | 20 | 20 | 0 |
| 50 / 50 | 40 | 21 | 19 |
| 0 / 100 に更新中〜更新後 | 140 | 1 | 139 |
最後に、使わなくなった blue を CLI で消した。
削除を始めてから 4 分間に送った 400 回は、すべて green が答え、エラーはなかった。
個々のデプロイを消しても、エンドポイントのほかのデプロイには影響しない。
az ml online-deployment delete -g rg-ar25-ml -w mlw-ar25 -e ep-ar25-rent -n blue --yes --no-wait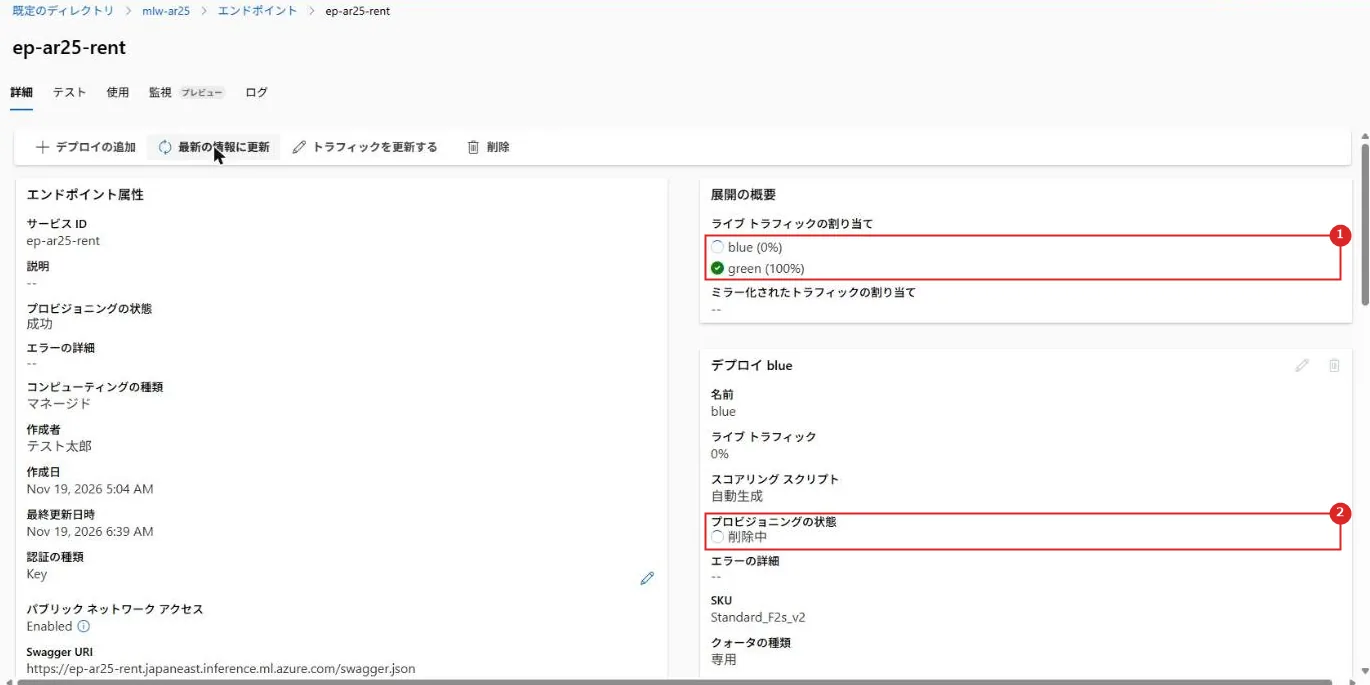
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | ライブ トラフィックの割り当て | green(100%)、blue(0%) |
| 2 | プロビジョニングの状態 | blue は削除中 |
公式ドキュメント:リアルタイム推論のために新しいデプロイの安全なロールアウトを実行する | Microsoft Learn
実機でつまずいた点
Liveness probe failed: HTTP probe failed with statuscode: 502.
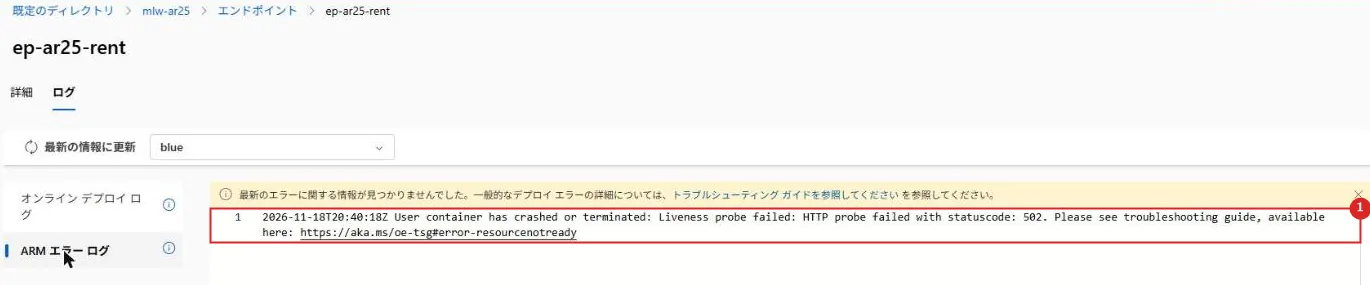
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | ARM エラー ログ | User container has crashed or terminated: Liveness probe failed: HTTP probe failed with statuscode: 502. |
最初の blue は、約 35 分「作成中」のあと失敗した。
作成中は、CLI でログを取ろうとしても Deployment is in deleting or creating state so logs can’t be retrieved. と出て、中が見えない。
失敗したあとにデプロイのログを見ると、推論サーバーの起動で pandas が見つからずに止まっていた。
$ az ml online-deployment get-logs -g rg-ar25-ml -w mlw-ar25 -e ep-ar25-rent -n blue
...
  File ".../site-packages/mlflow/pyfunc/__init__.py", line 417, in <module>
ModuleNotFoundError: No module named 'pandas'
azureml_inference_server_http.server.user_script.UserScriptImportException: Failed to import user script because it raised an unhandled exception
...
Reason: Worker failed to boot.
コードなしのデプロイでは、モデルの conda.yaml に書いたパッケージで環境が作られる。
最初の conda.yaml は mlflow-skinny と scikit-learn だけで、pandas が入っていなかった。
pandas を足すと、次は自動で用意されるスコアリング スクリプト(mlflow_score_script.py)の from azureml.ai.monitoring import Collector で、No module named ‘azureml’ になった。
公式の「MLflow モデルのオンライン エンドポイントへのデプロイ」には、環境に azureml-inference-server-http と azureml-ai-monitoring を含める必要があると書かれている。
例の conda.yaml に合わせて cloudpickle、psutil、pandas、azureml-inference-server-http、azureml-ai-monitoring を足し、新しいバージョンとして登録し直すと、約 15 分で成功した。
直すたびに、新しいバージョンとして登録した(今回は 1 → 3 → 5)。
MLflow 形式のフォルダーを手で書くときは、この 2 つのパッケージを忘れない。
公式ドキュメント:MLflow モデルのオンライン エンドポイントへのデプロイ | Microsoft Learn
推奨構成
| 項目 | 推奨 |
|---|---|
| 環境 | Dev、Stage、Prod を別のサブスクリプション。 ワークスペースと AKS は環境ごと |
| 昇格 | 共有プラットフォームのサブスクリプションに 1 つのレジストリ。 書き込みは Dev の昇格パイプラインだけ |
| 受信 | Application Gateway(WAF)→ API Management(内部モード、トークン交換)→ 推論ルーター(内部ロード バランサー) |
| ネットワーク | マネージド VNet と自分の VNet。 ハイブリッド DNS は DNS Private Resolver |
| リリース | 0% から始めるブルー/グリーンと、監視のしきい値でのロールバック |
注意事項
| 項目 | 内容 |
|---|---|
| AKS のサブスクリプション | Azure Machine Learning は、別のサブスクリプションの AKS クラスターのアタッチに対応していない |
| レジストリのリソース | レジストリの裏の Storage と Container Registry は、azureml-rg-<レジストリ名>_ プライベート エンドポイント、ポリシー、コストで考慮する |
| レジストリでの環境の作成 | レジストリの Container Registry がパブリック アクセスを無効にしていると、レジストリで環境を直接作れない。 Dev のワークスペースで作って共有する |
| ワークスペースのロール | 2024 年 11 月 19 日より前に作ったワークスペースは、マネージド ID に共同作成者が付いている。 Azure AI 管理者に置き換える |
| 範囲 | ストリーミング推論は範囲外。1 つのリージョンの構成 |
公式ドキュメント:ベースライン Azure Machine Learning推論参照アーキテクチャ | Microsoft Learn
関連するアーキテクチャとの違い
| 記事 | このアーキテクチャとの関係 |
|---|---|
| 基本の Foundry チャットとランディング ゾーン版 | 生成 AI のチャット。今回は自分で学習させたモデルのオンライン推論 |
| Azure Machine Learning のセキュリティとは(AI 編 A7) | Azure Machine Learning のワークスペースとネットワークを扱った |
| AKS のベースライン アーキテクチャ | 推論のホストになる AKS の基盤 |
まとめ
・Azure Machine Learning 推論のベースラインは、Dev・Stage・Prod を別のサブスクリプションに分け、共有のレジストリを昇格のゲートにする。
・推論は AKS の Kubernetes オンライン エンドポイントで、ブルー/グリーンで段階的にトラフィックを移す。
・受信は Application Gateway(WAF)と内部モードの API Management で、API Management が Azure Machine Learning のトークンに交換する。
・ネットワークは、マネージド コンピューティング用のマネージド VNet と、それ以外の自分の VNet の 2 つ。
次回:ドキュメントの分類の自動化(アーキテクチャ解説シリーズ 26)
コメント