
はじめに
DevOps 編の 17 回目は、監視と保守。
デプロイしたアプリを Azure Monitor と Application Insights で見て、問題が起きたらアラートで知らせ、アラートが出ている間はパイプラインのデプロイを止める。
あわせて、チームの流れを測る Azure DevOps の指標と、古い実行やパッケージを片付ける保持ポリシーを整理する。
実機では、App Service(F1)の Node.js アプリに OpenTelemetry を入れ、失敗した要求が増えたらアラートが出て、アラート中はデプロイがチェックで止まり、解決すると進むところまで確かめた。
Log Analytics ワークスペースと、環境のチェックは次の記事でも扱っている。
前回はセキュリティ スキャンだった。
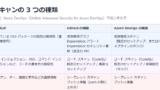
DevOps で監視するもの
監視の対象は、アプリ、インフラ、パイプライン、チームの流れの 4 つに分けられる。
アプリとインフラは Azure Monitor、パイプラインとチームの流れは Azure DevOps の分析機能で測る。
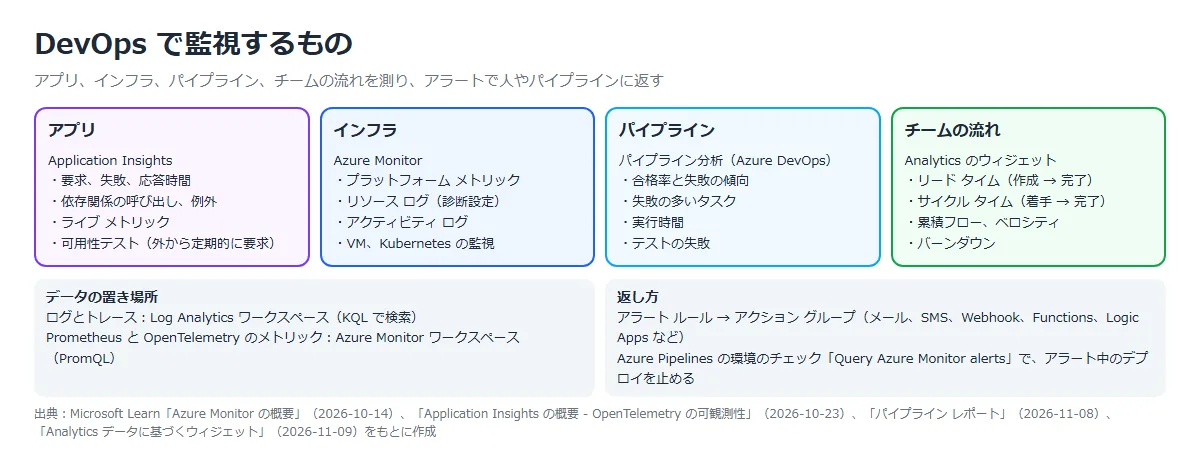
Azure Monitor は、クラウドとハイブリッドの環境からテレメトリを集めて分析する統合の可観測サービス。
ログとトレースは Log Analytics ワークスペースに入って KQL で、Prometheus と OpenTelemetry のメトリックは Azure Monitor ワークスペースに入って PromQL で分析する。
名前は似ているが、別の種類のリソース。
公式ドキュメント:Azure Monitor の概要 | Microsoft Learn
Application Insights と OpenTelemetry
Application Insights は、Azure Monitor のアプリケーション パフォーマンス監視(APM)の機能。
OpenTelemetry でアプリを計測し、アプリケーション マップ、障害、パフォーマンス、ライブ メトリック、可用性などの画面で見る。
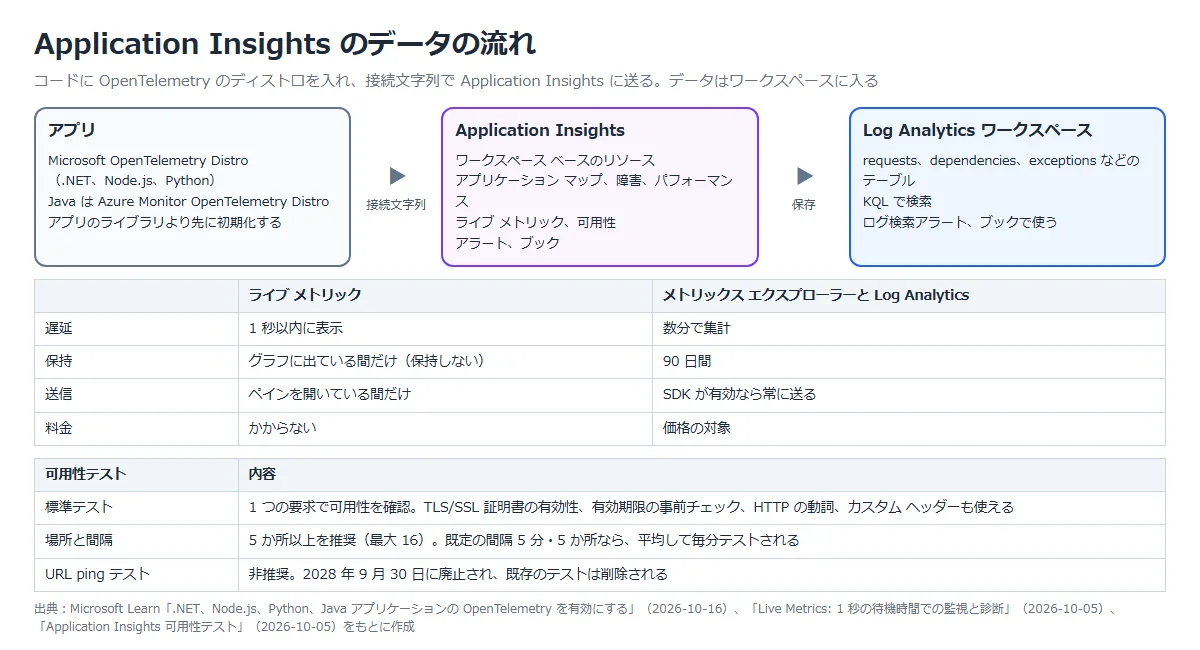
データを集める方法
| 方法 | 内容 |
|---|---|
| コードで計測(推奨) | .NET、Node.js、Python は Microsoft OpenTelemetry Distro、Java は Azure Monitor OpenTelemetry Distro を使う。 Node.js は 22 以降が必要で、パッケージは @microsoft/opentelemetry |
| App Service の自動計測 | ポータルの「Application Insights」⇒「有効にする」で、コードを変えずに有効にできる(対応するスタックのみ)。 Linux の Node.js の自動計測はパブリック プレビュー |
| 接続文字列 | どちらも接続文字列で Application Insights のリソースにつなぐ。 環境変数 APPLICATIONINSIGHTS_CONNECTION_STRING で渡せる |
既存の Azure Monitor OpenTelemetry Distro を使っているアプリは、新しいディストロに移る必要はない。
ただし、同じアプリで 2 つのディストロを両方初期化してはいけない。
公式ドキュメント:
Application Insights の概要 – OpenTelemetry の可観測性 | Microsoft Learn
.NET、Node.js、Python、Java アプリケーションの OpenTelemetry を有効にする | Microsoft Learn
Azure App Service の監視 | Microsoft Learn
ライブ メトリック
ライブ メトリックは、要求、失敗、依存関係、CPU、メモリなどを 1 秒以内の遅れで見る画面。
Node.js の OpenTelemetry では既定で有効になっている。
データはペインを開いている間だけ流れ、保持されず、料金もかからない。
修正をリリースしている最中に、失敗の数が減ったかをその場で確かめる使い方ができる。
公式ドキュメント:Live Metrics: 1 秒の待機時間での監視と診断 | Microsoft Learn
可用性テスト
可用性テストは、世界の複数の場所から一定の間隔でアプリに要求を送り、応答しないときや遅いときに知らせる。
アプリを変更する必要はなく、インターネットから届く HTTP/HTTPS のエンドポイントなら何でも使える。
今の主力は標準テストで、TLS/SSL 証明書の有効性や有効期限の事前チェックもできる。
テストの場所は 5 か所以上が推奨で、最大 16 か所。
再試行を有効にすると、3 回続けて失敗したときだけ失敗として報告される。
URL ping テストは非推奨で、2028 年 9 月 30 日に廃止される。
公式ドキュメント:Application Insights 可用性テスト | Microsoft Learn
Log Analytics と KQL
Application Insights のデータは、Log Analytics ワークスペースの requests、dependencies、exceptions などのテーブルに入る。
KQL(Kusto 照会言語)で検索し、同じクエリをログ検索アラート、ブック、Azure ダッシュボードで使える。
クエリは Log Analytics で作って試してから、アラートなどにコピーするのが一般的。
| 使う場所 | 内容 |
|---|---|
| Log Analytics | ポータルでクエリを書いて、結果を対話的に分析する |
| ログ検索アラート | 一定の間隔でクエリを実行し、結果でアラートを出すか決める |
| ブック(Workbooks) | テキスト、ログ クエリ、メトリック、パラメーターを組み合わせた対話型のレポート |
| API、クライアント ライブラリ | REST や .NET、Java、JavaScript、Python からクエリを実行する |
ブックの閲覧には監視閲覧者、共有ブックの保存には監視共同作成者などのロールを使う。
公式ドキュメント:
Azure Monitor でのログ クエリ | Microsoft Learn
Azure ワークブック | Microsoft Learn
アラートとアクション グループ
アラート ルールは、監視対象のリソース、シグナル、条件を組み合わせたもの。
条件を満たすとアラートが発生し、関連付けたアクション グループが通知や自動化を動かす。
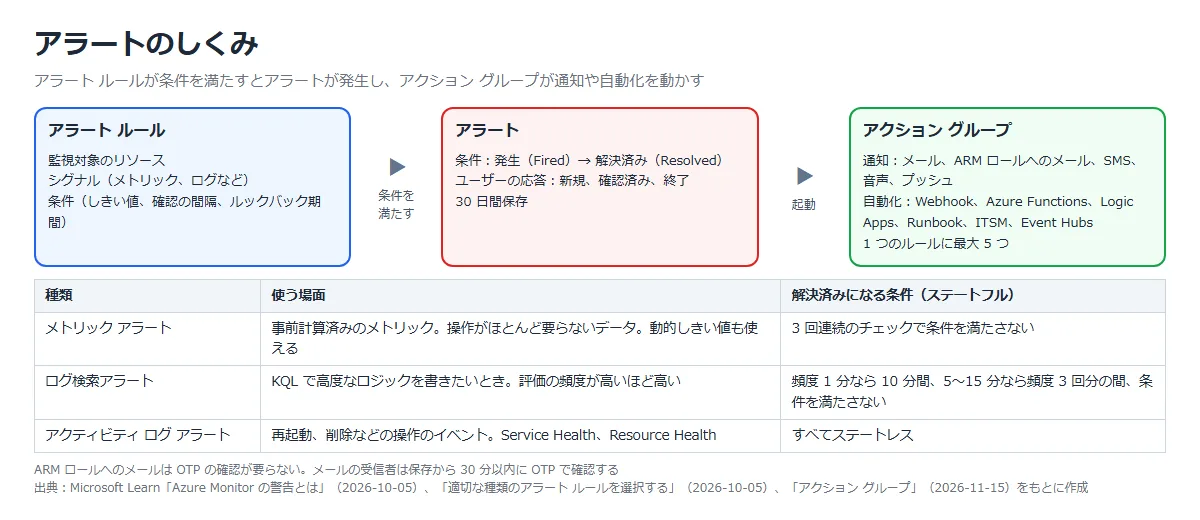
メトリック アラートは既定でステートフルで、発生したあとは解決するまでもう一度発生しない。
3 回連続のチェックで条件を満たさなくなると、解決済みになり、解決の通知も送られる。
アラートは 30 日間保存される。
アクション グループは、1 つのアラート ルールに最大 5 つまで付けられ、複数のルールで使い回せる。
メールの受信者は、保存から 30 分以内にワンタイム パスコードで確認する必要がある。
Azure Resource Manager のロール(所有者など)へのメールは、この確認が要らない。
費用は種類で決まり、メトリック アラートは監視する時系列の数、ログ検索アラートは評価の間隔で課金される。
評価の頻度が高いほど高くなる。
公式ドキュメント:
Azure Monitor の警告とは | Microsoft Learn
適切な種類のアラート ルールを選択する | Microsoft Learn
アクション グループ | Microsoft Learn
パイプラインと監視をつなぐ
Azure Pipelines では、環境やサービス接続に「Query Azure Monitor alerts」のチェックを付けられる。
評価のときにどのアラート ルールも発生していなければ成功し、発生していれば失敗して、設定した間隔で評価し直す。
タイムアウトまでに成功しなければ、そのステージは実行されない。
カナリア デプロイや段階的なロールアウトで、前の段階のあとにアプリを一定時間観察し、アラートが出ていなければ次へ進める、という使い方が想定されている。
| 順番 | チェックの分類 |
|---|---|
| 1 | 静的チェック:ブランチ管理、必須テンプレート、成果物の評価 |
| 2 | 事前チェックの承認 |
| 3 | 動的チェック:承認、Azure Functions の呼び出し、REST API の呼び出し、営業時間、Azure Monitor アラートの照会 |
| 4 | チェック後の承認 |
| 5 | 排他ロック |
公式ドキュメント:承認とチェックを定義する | Microsoft Learn
チームの指標
Azure DevOps の Analytics は、Azure DevOps Services のすべての組織で有効になっている。
ダッシュボードに Analytics のウィジェットを置くと、チームの流れを数字で見られる。
| ウィジェット | 測るもの |
|---|---|
| リード タイム | 作業項目が作成されてから完了するまでの時間。 配送の見積もりや SLA の追跡に使う |
| サイクル タイム | 作業項目が最初に進行中になってから完了するまでの時間。 プロセスのボトルネックを見つけるのに使う |
| 累積フロー図 | ボードの列ごとの作業項目の数の推移 |
| ベロシティ | スプリントでチームが完了できる作業量 |
| テスト結果の傾向(詳細) | パイプラインのテストの合格率や時間の推移 |
リード タイムとサイクル タイムのウィジェットには、Basic 以上のアクセス レベルが必要。
作業の進みに合わせて作業項目の状態をすぐ更新しないと、グラフが役に立たない。
パイプラインの「Analytics」タブには、合格率、実行時間、テストの失敗のレポートがある。
既定は過去 14 日間で、失敗の多いタスクから直す順番を決められる。
公式ドキュメント:
Analytics データに基づくウィジェット | Microsoft Learn
リード タイムウィジェットとサイクルタイム ウィジェットを構成する | Microsoft Learn
パイプライン レポート | Microsoft Learn
保守
保守では、古い実行や成果物、パッケージを自動で片付け、依存関係を新しく保つ。
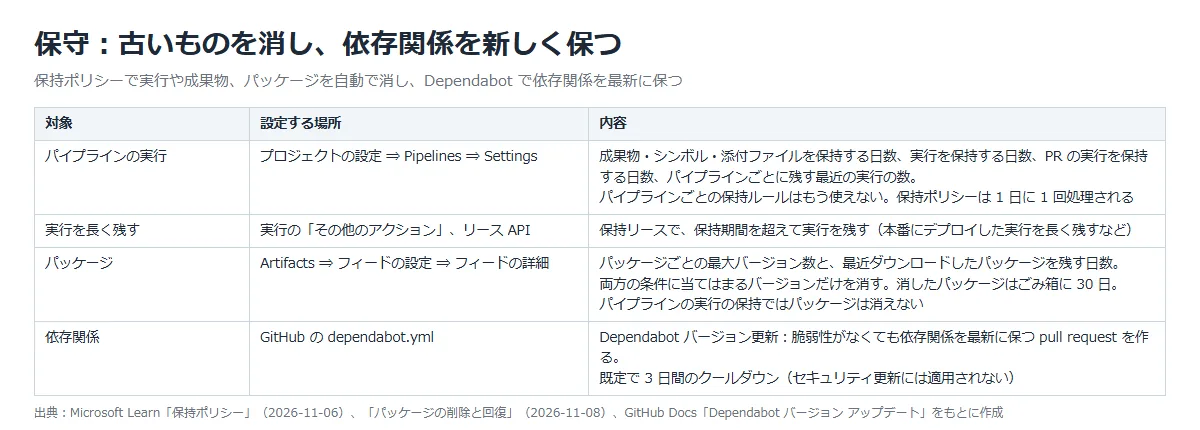
パイプラインの実行の保持は、プロジェクトの設定でまとめて決める。
パイプラインごとの保持ルールはもうサポートされていない。
保持ポリシーで残るのは成功と一部成功の実行だけで、処理は 1 日に 1 回。
本番にデプロイした実行などを長く残したいときは、保持リースを使う。
パイプラインの実行の保持では、Azure Artifacts のパッケージは消えない。
パッケージはフィードの保持ポリシーで、バージョン数の上限と、ダウンロードされていない日数の両方に当てはまるものを消す。
消したパッケージはごみ箱に 30 日間残り、その間は戻せる。
GitHub の Dependabot バージョン更新は、脆弱性がなくても依存関係を最新に保つ pull request を作る。
dependabot.yml をリポジトリに置いて有効にし、既定では新しいバージョンのリリースから 3 日間のクールダウンがある。
セキュリティ更新(D16)にはクールダウンは適用されない。
公式ドキュメント:
保持ポリシー | Microsoft Learn
パッケージの削除と回復 | Microsoft Learn
参考:Dependabot バージョン アップデート – GitHub Docs
構築手順
今回の構成と実施すること
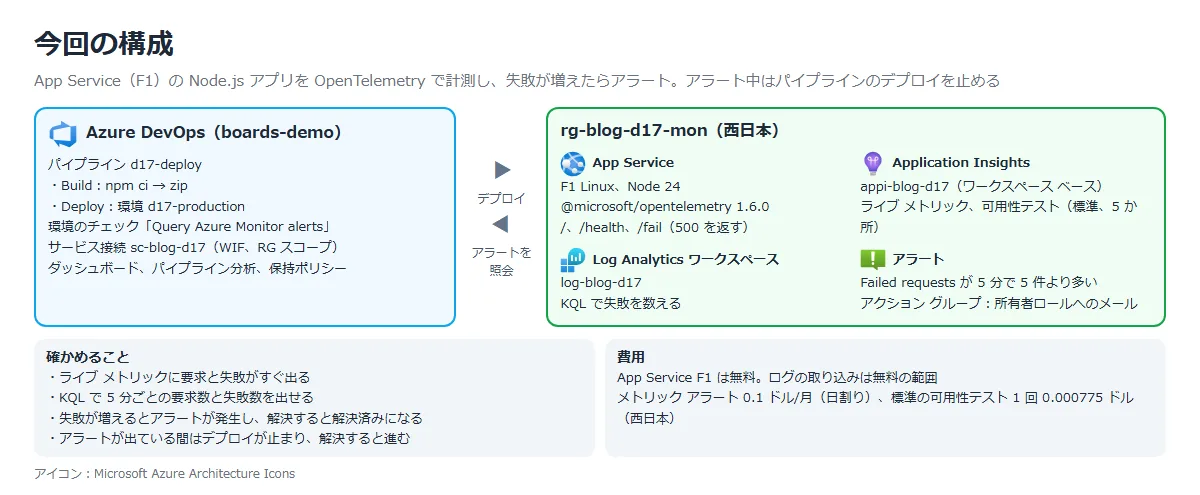
| 手順 | 実施すること | 確かめること |
|---|---|---|
| ① | App Service(F1)と Log Analytics ワークスペースを作る | ― |
| ② | Application Insights を作り、アプリに OpenTelemetry を入れてパイプラインでデプロイする | ライブ メトリックに要求と失敗がすぐ出る |
| ③ | KQL で 5 分ごとの要求数と失敗数を出す | 失敗した要求を数えられる |
| ④ | 失敗した要求のアラート ルールとアクション グループを作る | 失敗が増えるとアラートが発生する |
| ⑤ | 環境に「Query Azure Monitor alerts」のチェックを付けて、パイプラインを実行する | アラート中はデプロイが止まり、解決すると進む |
| ⑥ | 可用性テスト、ダッシュボード、パイプライン分析、保持ポリシーを見る | 外からの監視、チームの指標、保持の既定値 |
① App Service と Log Analytics ワークスペースを作る
リソース グループ、F1 の Linux プラン、Node 24 の Web アプリ、Log Analytics ワークスペースを、西日本に CLI で作った。
az group create -n rg-blog-d17-mon -l japanwest
az appservice plan create -g rg-blog-d17-mon -n asp-blog-d17 --sku F1 --is-linux -l japanwest
az webapp create -g rg-blog-d17-mon -p asp-blog-d17 -n app-blog-d17-9584 --runtime "NODE:24-lts"
az monitor log-analytics workspace create -g rg-blog-d17-mon -n log-blog-d17 -l japanwest
② Application Insights を作り、OpenTelemetry を入れる
ポータルの「Application Insights」⇒「作成」で、ワークスペースに ① の log-blog-d17 を選んで作った。
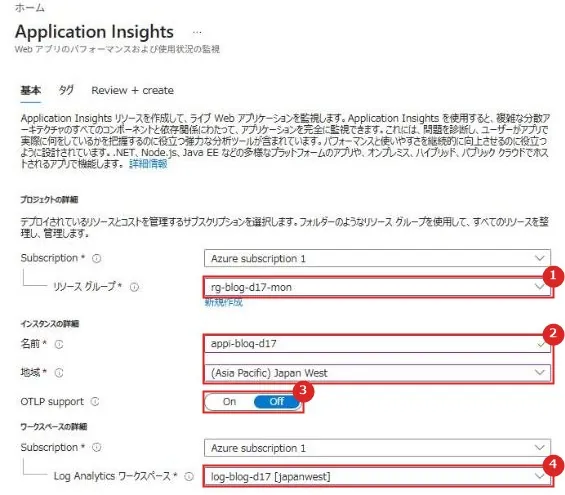
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | リソース グループ | rg-blog-d17-mon |
| 2 | 名前、地域 | appi-blog-d17、Japan West |
| 3 | OTLP support | Off のまま(既定)。 今回はディストロの Azure Monitor エクスポーターで送る |
| 4 | Log Analytics ワークスペース | データを入れるワークスペース。 ワークスペース ベースのリソースになる |
アプリは Node.js の http モジュールだけの小さなもので、/ と /health は 200、/fail はわざと 500 を返す。
先頭で Microsoft OpenTelemetry Distro を初期化する。
// 計測ライブラリを読み込む前に初期化する
const { useMicrosoftOpenTelemetry } = require('@microsoft/opentelemetry');
useMicrosoftOpenTelemetry({
  azureMonitor: {
    azureMonitorExporterOptions: {
      connectionString: process.env.APPLICATIONINSIGHTS_CONNECTION_STRING,
    },
  },
});

const http = require('http');
const server = http.createServer((req, res) => {
  if (req.url === '/health') { res.writeHead(200); return res.end('ok'); }
  if (req.url === '/fail') { res.writeHead(500); return res.end('error'); }
  res.writeHead(200);
  res.end('d17 monitor demo v1\n');
});
server.listen(process.env.PORT || 8080);
npm install @microsoft/opentelemetry で 1.6.0 を入れ、接続文字列は CLI で取ってアプリ設定で渡した。
az resource show -g rg-blog-d17-mon -n appi-blog-d17 --resource-type microsoft.insights/components --query properties.ConnectionString -o tsv
az webapp config appsettings set -g rg-blog-d17-mon -n app-blog-d17-9584 --settings "APPLICATIONINSIGHTS_CONNECTION_STRING=<接続文字列>"
デプロイは Azure Pipelines の d17-deploy で行った。
Build で npm ci と zip、Deploy で環境 d17-production に AzureWebApp@1 でデプロイする。
サービス接続 sc-blog-d17 は、ワークロード ID フェデレーションでリソース グループのスコープにした(D15)。
stages:
  - stage: Build
    jobs:
      - job: build
        steps:
          - script: npm ci --omit=dev
            workingDirectory: d17
          - task: ArchiveFiles@2
            inputs:
              rootFolderOrFile: d17
              includeRootFolder: false
              archiveFile: $(Build.ArtifactStagingDirectory)/app.zip
          - publish: $(Build.ArtifactStagingDirectory)/app.zip
            artifact: app

  - stage: Deploy
    dependsOn: Build
    jobs:
      - deployment: production
        environment: d17-production
        strategy:
          runOnce:
            deploy:
              steps:
                - task: AzureWebApp@1
                  inputs:
                    azureSubscription: sc-blog-d17
                    appType: webAppLinux
                    appName: app-blog-d17-9584
                    package: $(Pipeline.Workspace)/app/app.zip
デプロイのあと、/ と /health に 2 秒ごとに要求を送り、5 回に 1 回 /fail を混ぜた。
Application Insights の「ライブ メトリック」を開くと、要求と失敗がすぐに出た。
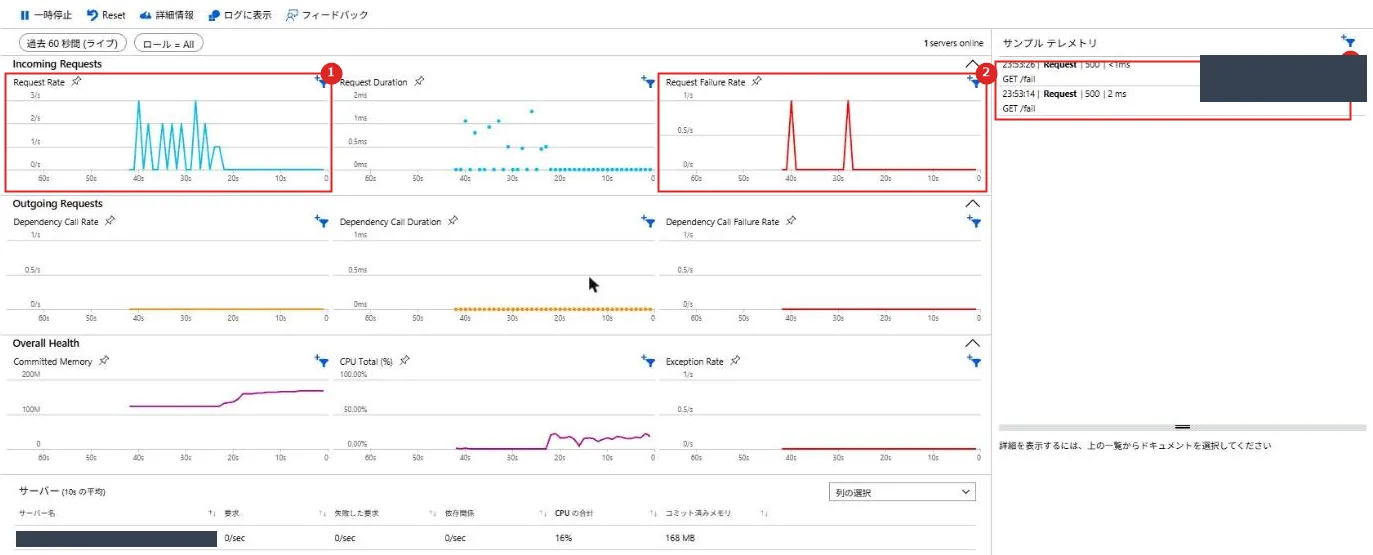
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | Request Rate | 1 秒あたりの要求数 |
| 2 | Request Failure Rate | 失敗した要求の割合。 /fail の 500 が山になって出る |
| 3 | サンプル テレメトリ | 失敗した要求のサンプル(GET /fail、500) |
公式ドキュメント:
.NET、Node.js、Python、Java アプリケーションの OpenTelemetry を有効にする | Microsoft Learn
Live Metrics: 1 秒の待機時間での監視と診断 | Microsoft Learn
③ KQL で失敗を数える
Application Insights の「ログ」を KQL モードにして、5 分ごとの要求数と失敗数を出した。
requests
| where timestamp > ago(1h)
| summarize total = count(), failed = countif(success == false) by bin(timestamp, 5m)
| order by timestamp asc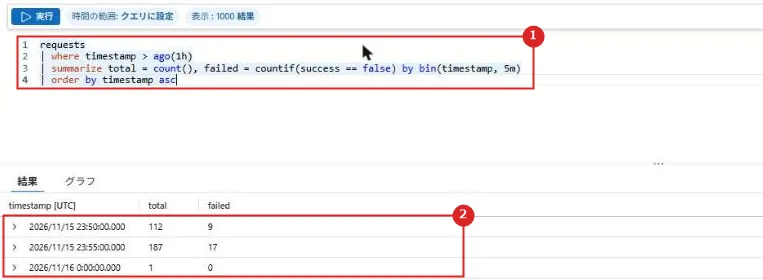
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | クエリ | requests テーブルを 5 分ごとに集計。 success が false の要求を数える |
| 2 | 結果 | 23:50(UTC)からの 5 分は 112 件中 9 件、23:55 からの 5 分は 187 件中 17 件が失敗 |
公式ドキュメント:Azure Monitor でのログ クエリ | Microsoft Learn
④ アラート ルールとアクション グループを作る
Application Insights の「アラート」⇒「作成」⇒「アラート ルール」で、シグナルに「Failed requests」を選んだ。
しきい値は 5 にし、5 分間の失敗した要求の数が 5 より大きいときに発生するようにした。
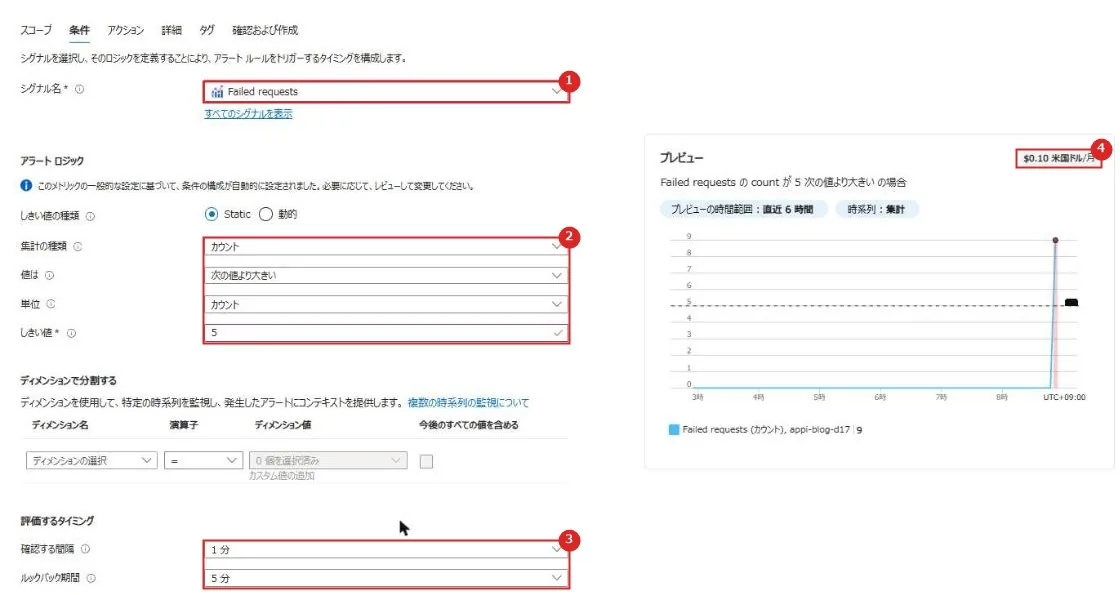
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | シグナル名 | Failed requests(Application Insights のメトリック) |
| 2 | アラート ロジック | Static、集計はカウント、「次の値より大きい」、しきい値 5 |
| 3 | 評価するタイミング | 確認する間隔 1 分、ルックバック期間 5 分(既定) |
| 4 | 見積もり | 0.10 米国ドル/月 |
「アクション」で「アクション グループの作成」を選び、通知の種類を「Azure Resource Manager のロールへのメール」、ロールを「所有者」にした。
ARM ロールへのメールは、ワンタイム パスコードの確認が要らない。
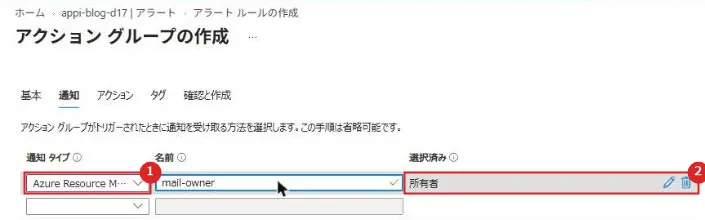
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | 通知タイプ | Azure Resource Manager のロールへのメール |
| 2 | 選択済み | 所有者。 サブスクリプションの所有者にメールが届く |
「詳細」で重大度を「2 – 警告」、名前を alert-d17-failed-requests にして作った。
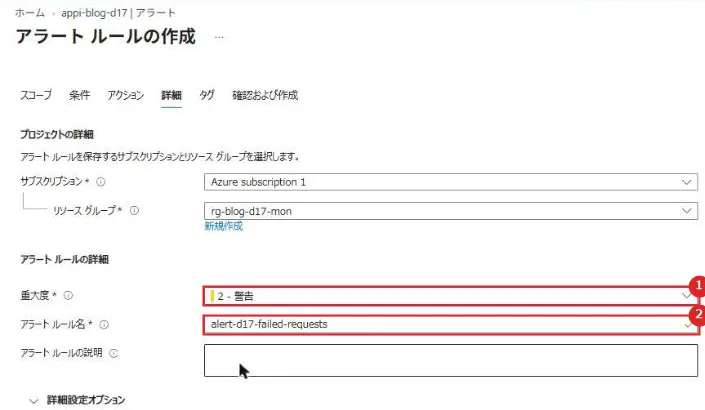
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | 重大度 | 2 – 警告(Sev2) |
| 2 | アラート ルール名 | alert-d17-failed-requests |
ルールを作ってから約 3 分で、アラートが発生した。
発生したときの値は 22 で、しきい値の 5 を超えていた。
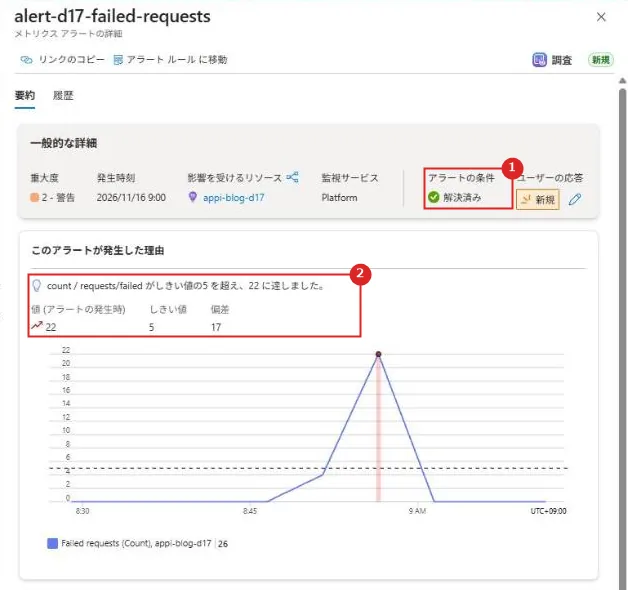
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | アラートの条件 | この画面は解決したあとに撮ったので「解決済み」 |
| 2 | このアラートが発生した理由 | count / requests/failed がしきい値の 5 を超え、22 に達した |
公式ドキュメント:
Azure Monitor の警告とは | Microsoft Learn
アクション グループ | Microsoft Learn
⑤ アラート中はデプロイを止める
Pipelines ⇒ Environments ⇒ d17-production ⇒「Approvals and checks」⇒「View all checks」で「Query Azure Monitor alerts」を選んだ。
サービス接続とリソース グループを選ぶと、そのリソース グループのアラートを照会する。
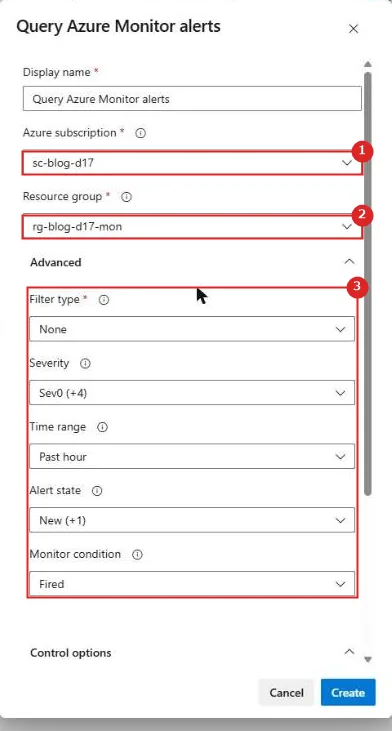
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | Azure subscription | サービス接続 sc-blog-d17 |
| 2 | Resource group | rg-blog-d17-mon |
| 3 | Advanced | Filter type、Severity(Sev0 +4)、Time range(Past hour)、Alert state(New +1)、Monitor condition(Fired)。 今回は既定のまま |
「Control options」で、タイムアウトを 30 分、評価の間隔を 5 分にした。
タイムアウトの既定は 1440 分、評価の間隔の既定は 0 分だった。
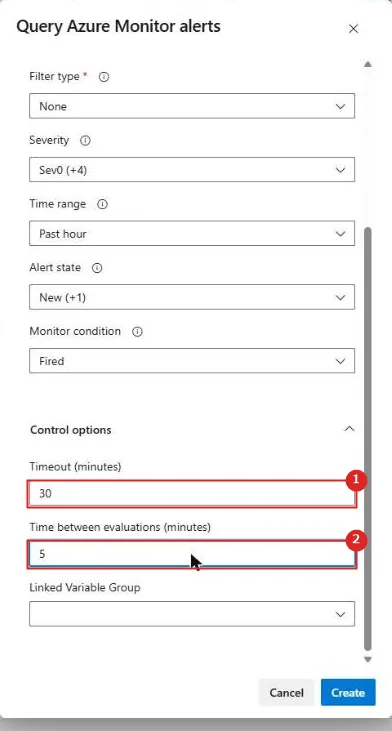
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | Timeout (minutes) | 30。 この間に成功しなければステージは実行されない |
| 2 | Time between evaluations (minutes) | 5。 失敗したら 5 分後に評価し直す |
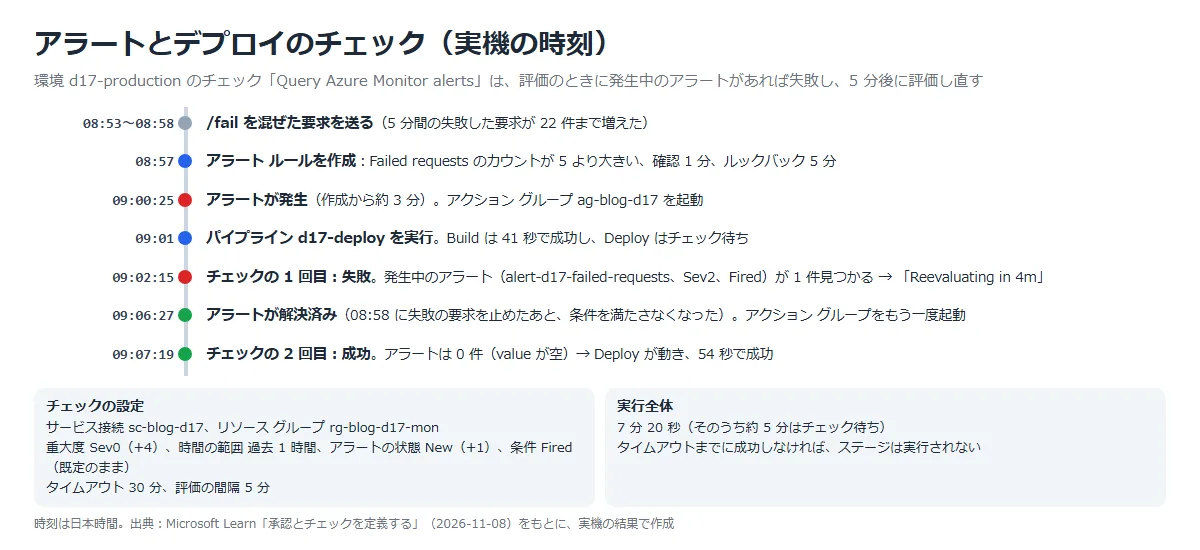
アラートが発生している 09:01 にパイプラインを実行した。
Build は成功し、Deploy はチェック待ちになった。
チェックの 1 回目は、発生中のアラートを 1 件見つけて失敗し、「Reevaluating in 4m」と出た。
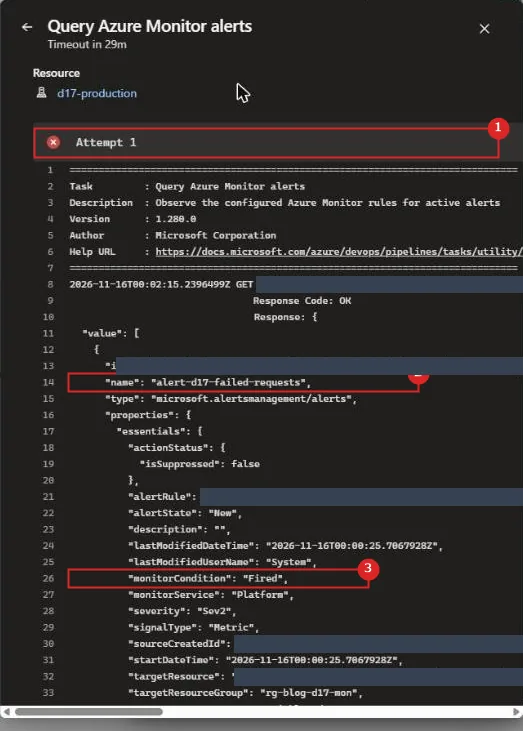
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | Attempt 1 | 失敗(×) |
| 2 | name | alert-d17-failed-requests |
| 3 | monitorCondition | Fired(発生中) |
要求を止めてしばらくすると、アラートは解決済みになった。
アラートの「履歴」には、発生、アクション グループの起動 2 回(発生時と解決時)、解決が並んだ。
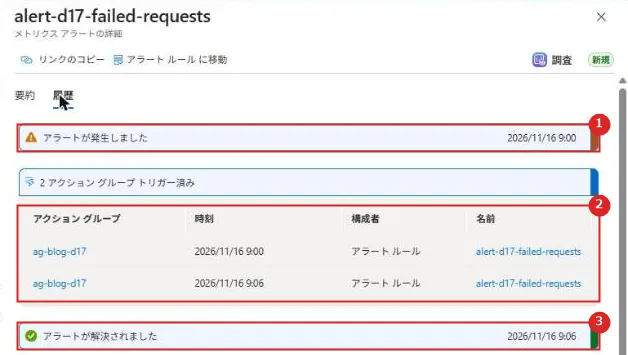
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | アラートが発生しました | 9:00 |
| 2 | アクション グループ トリガー済み | ag-blog-d17 が 9:00 と 9:06 に起動 |
| 3 | アラートが解決されました | 9:06 |
チェックの 2 回目(09:07)では、アラートが 0 件(value が空)で成功し、Deploy が 54 秒で終わった。
実行全体は 7 分 20 秒で、そのうち約 5 分がチェック待ちだった。
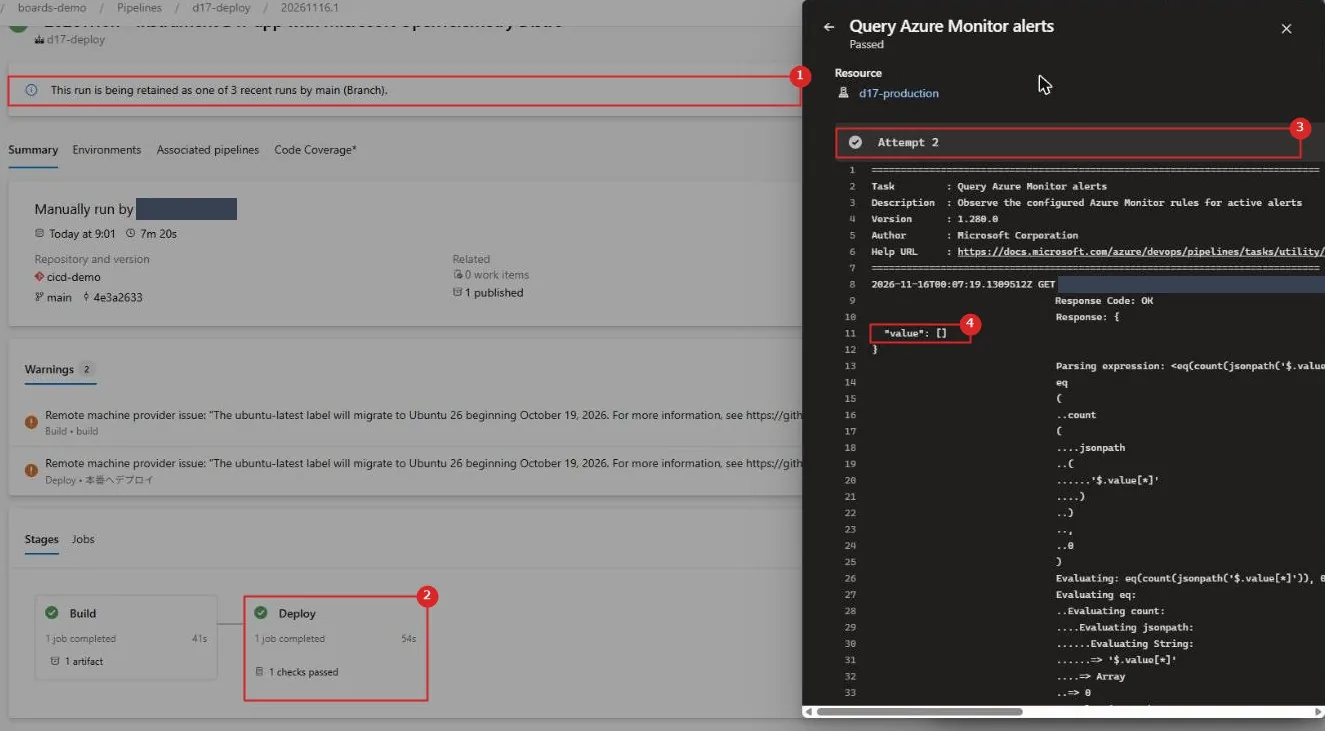
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | 保持のメッセージ | 「This run is being retained as one of 3 recent runs by main (Branch).」 保持ポリシーの「最近の実行 3 件」で残っている |
| 2 | Deploy | 1 checks passed で成功 |
| 3 | Attempt 2 | 成功 |
| 4 | value | 発生中のアラートが 0 件 |
流れを時刻で並べると次のとおり。
公式ドキュメント:
承認とチェックを定義する | Microsoft Learn
Azure Monitor の警告とは | Microsoft Learn
⑥ 可用性テスト、ダッシュボード、保持ポリシーを見る
Application Insights の「可用性」⇒「標準テストの追加」で、/health を 5 分ごとに 5 か所から確認するテストを作った。
標準テストの実行は 1 回あたり 0.000775 ドル(Retail Prices API、西日本、2026-11-16 時点)。
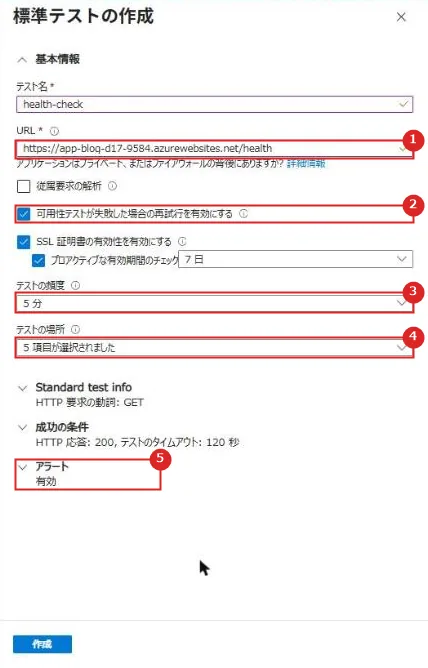
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | URL | https://app-blog-d17-9584.azurewebsites.net/health |
| 2 | 再試行 | オン(既定)。 3 回続けて失敗したときだけ失敗として報告する |
| 3 | テストの頻度 | 5 分(既定) |
| 4 | テストの場所 | 5 か所(既定) |
| 5 | アラート | 有効(既定)。 テスト用のアラート ルールも作られる |
数分で結果が出て、5 か所すべてで 100%、成功 10 回だった。
場所ごとの平均時間は、Japan East が 249 ms、Brazil South が 1.18 秒と差があった。
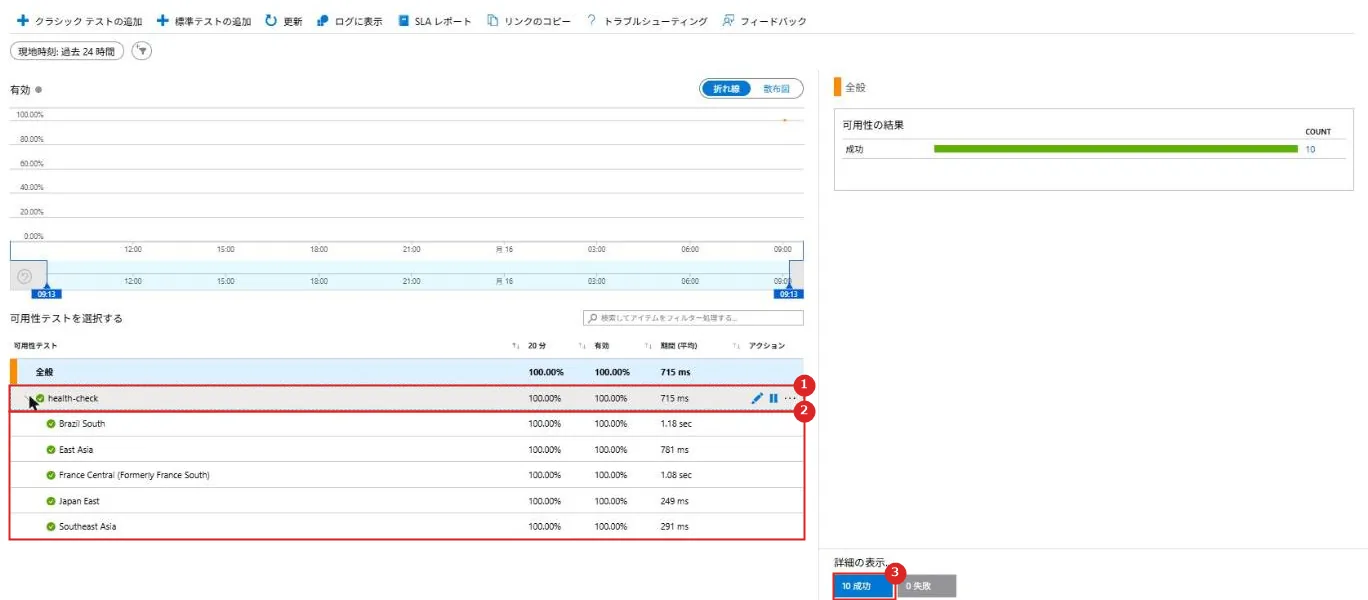
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | health-check | 過去 20 分の可用性 100%、平均 715 ms |
| 2 | テストの場所 | Brazil South、East Asia、France Central、Japan East、Southeast Asia |
| 3 | 成功 | 10 回成功、0 回失敗 |
Azure DevOps では、ダッシュボードを作ってリード タイム、サイクル タイム、ビルド履歴のウィジェットを置いた。
この検証用プロジェクトは完了した作業項目が 1 件だけなので、数字は 0 日になった。
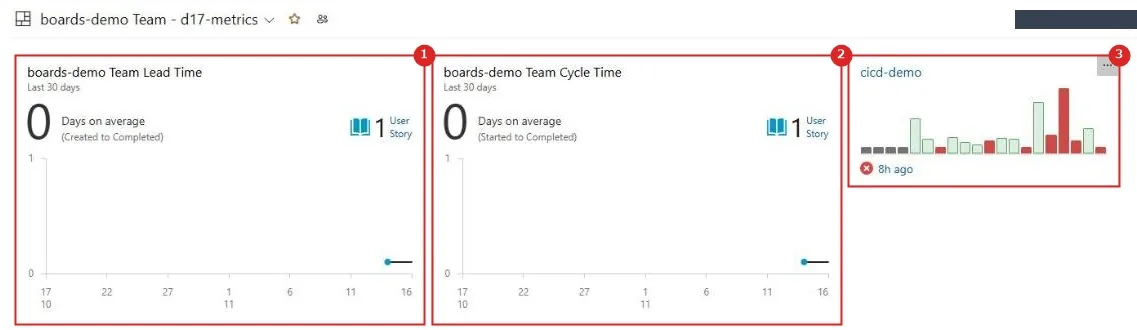
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | Lead Time | 作成から完了まで(過去 30 日) |
| 2 | Cycle Time | 着手から完了まで(過去 30 日) |
| 3 | Build History | cicd-demo パイプラインの実行の成功(緑)と失敗(赤) |
パイプラインの「Analytics」では、cicd-demo の過去 14 日の合格率が 56.25%(16 回中 9 回)と出た。
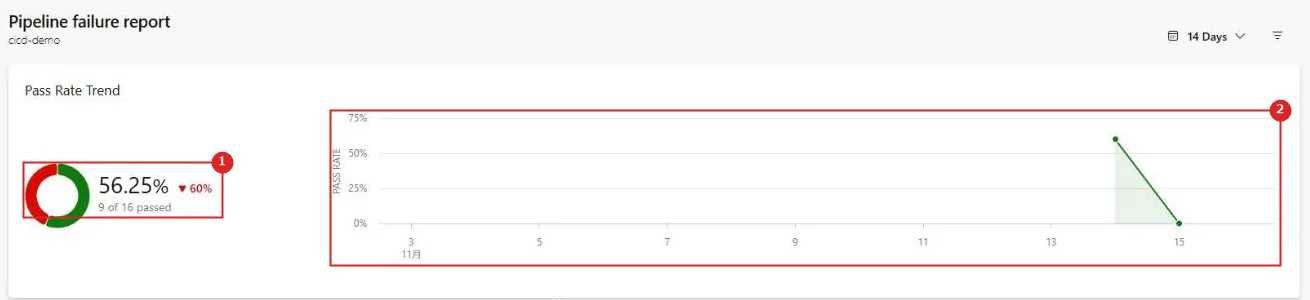
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | Pass Rate | 56.25%、9 of 16 passed |
| 2 | Pass Rate Trend | 日ごとの合格率の推移 |
プロジェクトの設定 ⇒ Pipelines ⇒ Settings の保持ポリシーは、成果物 30 日、実行 30 日、PR の実行 10 日、最近の実行 3 件だった。
「実行の保持の設定が先に評価されるので、成果物の設定は無視される」という警告も出ていた。
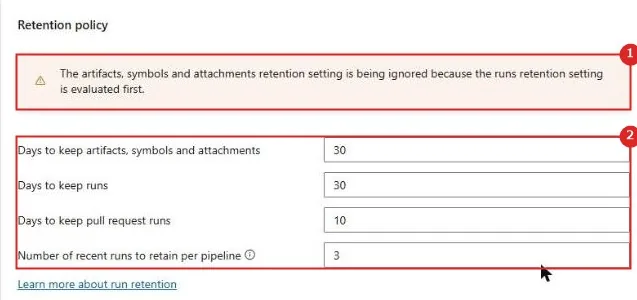
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | 警告 | The artifacts, symbols and attachments retention setting is being ignored because the runs retention setting is evaluated first. |
| 2 | 保持の設定 | Days to keep artifacts, symbols and attachments 30、Days to keep runs 30、Days to keep pull request runs 10、Number of recent runs to retain per pipeline 3 |
公式ドキュメント:
Application Insights 可用性テスト | Microsoft Learn
Analytics データに基づくウィジェット | Microsoft Learn
パイプライン レポート | Microsoft Learn
保持ポリシー | Microsoft Learn
片付け
リソース グループを削除し、パイプライン、環境、サービス接続、ダッシュボードを消した。
Application Insights を作ると、同じリソース グループに「Application Insights Smart Detection」のアクション グループと「Failure Anomalies」のアラート ルールもできていたので、リソース グループごと消すと残らない。
費用は、料金表から計算すると 1 円未満。
実機でつまずいた点
F1 では Application Insights が選べない
最初は、App Service の「Application Insights」⇒「有効にする」で、コードを変えずに計測するつもりだった。
ところが F1(Free)の Web アプリでは、左のメニューの「Application Insights」がグレーで選べず、「概要」の Application Insights の欄にも「サポートされていません」と出た。
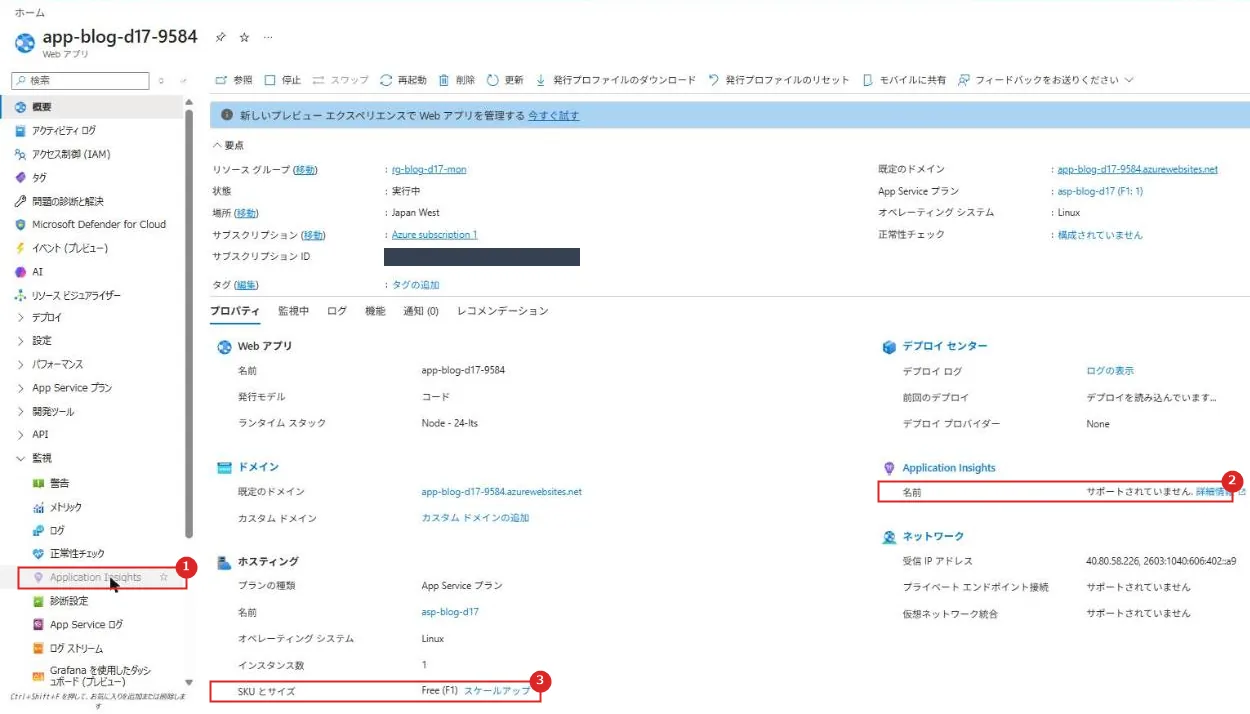
| 番号 | 項目 | 説明 |
|---|---|---|
| 1 | Application Insights | メニューがグレーで選べない |
| 2 | 概要の Application Insights | 「サポートされていません」 |
| 3 | SKU とサイズ | Free (F1) |
プランを上げずに進めるため、コードで計測する方法に切り替えた。
Microsoft OpenTelemetry Distro を入れて接続文字列を渡すと、F1 のままでもライブ メトリック、ログ、アラートまで使えた。
OpenTelemetry はコードで計測するので、App Service 以外の環境でも同じ書き方で使える。
発展
| 項目 | 内容 |
|---|---|
| ブック | KQL の結果、メトリック、説明文を 1 枚のレポートにまとめ、チームで共有する |
| ログ検索アラート | requests を KQL で絞り込み(特定の URL だけ、など)、その結果でアラートを出す |
| 段階的なロールアウト | カナリアの環境ごとに「Query Azure Monitor alerts」を付け、アラートがなければ次の環境へ進める(D12) |
| Dependabot バージョン更新 | dependabot.yml で npm や GitHub Actions の更新の pull request を定期的に受け取る |
公式ドキュメント:
Azure ワークブック | Microsoft Learn
適切な種類のアラート ルールを選択する | Microsoft Learn
推奨構成
| 項目 | 推奨 |
|---|---|
| アプリの計測 | Microsoft OpenTelemetry Distro(Java は Azure Monitor OpenTelemetry Distro)でコードから計測する |
| リソース | ワークスペース ベースの Application Insights にし、ログは Log Analytics ワークスペースに集める |
| 外からの監視 | 標準の可用性テストを 5 か所以上から。 URL ping テストは標準テストに移す |
| アラート | 失敗率や応答時間のメトリック アラートから始め、通知先はアクション グループで使い回す |
| デプロイ | 本番の環境に「Query Azure Monitor alerts」のチェックを付け、アラート中はデプロイしない |
| チームの指標 | リード タイム、サイクル タイム、パイプラインの合格率をダッシュボードで定期的に見る |
| 保守 | 保持ポリシーをプロジェクトの設定で決め、残したい実行は保持リースで残す。 パッケージはフィードの保持ポリシーで消す |
公式ドキュメント:
Application Insights の概要 – OpenTelemetry の可観測性 | Microsoft Learn
承認とチェックを定義する | Microsoft Learn
保持ポリシー | Microsoft Learn
注意事項
| 項目 | 内容 |
|---|---|
| F1 と自動計測 | 今回の F1 の Web アプリでは、ポータルの Application Insights が「サポートされていません」で選べなかった |
| 自動で作られるもの | Application Insights を作ると、Smart Detection のアクション グループと Failure Anomalies のアラート ルールが同じリソース グループにできた |
| ログの費用 | 取り込み量で課金される。 Retail Prices API の西日本の Analytics Logs の取り込みは、5 GB を超えた分が 1 GB あたり 3.57 ドル(2026-11-16 時点) |
| アラートの費用 | メトリック アラートは時系列の数、ログ検索アラートは評価の頻度で課金される |
| チェックの範囲 | 「Query Azure Monitor alerts」はリソース グループ内のアラートを照会する。 関係ないアラートでもデプロイが止まるので、フィルターで絞る |
| メールの確認 | メールの受信者は 30 分以内に OTP で確認しないと通知が届かない。 ARM ロールへのメールは確認が要らない |
| 保持ポリシー | パイプラインごとの保持ルールは使えない。 実行の保持ではパッケージは消えない |
公式ドキュメント:
Azure App Service の監視 | Microsoft Learn
アクション グループ | Microsoft Learn
保持ポリシー | Microsoft Learn
まとめ
・DevOps の監視は、アプリ、インフラ、パイプライン、チームの流れの 4 つを測る。
・アプリは OpenTelemetry で計測して Application Insights に送り、ライブ メトリック、KQL、可用性テストで見る。
・アラート ルールとアクション グループで、問題を人や自動化に返す。
・環境のチェック「Query Azure Monitor alerts」で、アラート中のデプロイを止め、解決したら進められる。
・リード タイム、サイクル タイム、パイプラインの合格率で、チームの流れを数字で見る。
・保持ポリシーと Dependabot で、古いものを片付けて依存関係を新しく保つ。
次回:DevOps 編のまとめ
コメント